 FYOS
06 · C++ · CUDA · v1.1.0 · MIT
FastLocalExperts
Ein 89-GB-Sprachmodell mit rund 90 Token pro Sekunde auf einer einzigen 32-GB-Grafikkarte.
- Token pro Sekunde beim Dekodieren
- ~90
- so schnell wie upstream llama.cpp – gleiche Datei, gleiche Karte
- 2,49×
- FLE-IQ3_M statt 93,68 GB, KLD im Messrauschen
- 88,87 GB
Wie läuft ein 89-GB-Modell auf einer 32-GB-Karte?
Aufmerksamkeit, geteilte Gewichte und ein Cache der meistgenutzten Experten liegen im VRAM, der Rest wartet im RAM. Trifft ein Token einen Experten im Cache, rechnet die GPU; fehlt er, rechnet die CPU zur selben Zeit. Der MTP-Kopf des Modells schlägt mehrere Token vor, das Hauptmodell prüft sie in einem Durchgang. So entstehen rund 90 Token pro Sekunde — lokal, ohne Cloud.
Was es ist
FLE ist ein Fork von llama.cpp für große Mixture-of-Experts-Modelle auf einer GPU plus CPU-Experten. Aufmerksamkeit, geteilte Gewichte und ein Cache heißer Experten liegen auf der GPU, der Großteil der Experten im Arbeitsspeicher. FLE treibt Rhea an, das lokale Sprachmodell hinter FYOS: Qwen3.8-Flash-Next mit 512 Experten je Schicht.
Was es kann
- Expertencache auf der GPU mit globalem Byte-Budget und Warmstart-Profil: ein neu gestarteter Server ist sofort warm.
- Überlappung. Cache-Treffer rechnet die GPU, Fehlgriffe gleichzeitig die CPU.
- Spekulatives Dekodieren mit dem MTP-Kopf des Modells, eingeschränkter Entwurfs-Vokabelliste und adaptiver Entwurfslänge.
- Vier Quantisierungen auf Hugging Face: FLE-IQ3_M, FLE-IQ3_XXS, FLE-IQ2_M und FLE-IQ3_M-REAP448 (448 von 512 Experten).
- 6.130 Messungen. Jede Tempozahl aus gepaarten Klammern; was nicht funktioniert hat, steht genauso im Bericht.
Making Rhea Fast
Acht kurze Filme über die Messungen hinter FLE. Wo Film und Bericht abweichen, gilt der Bericht.
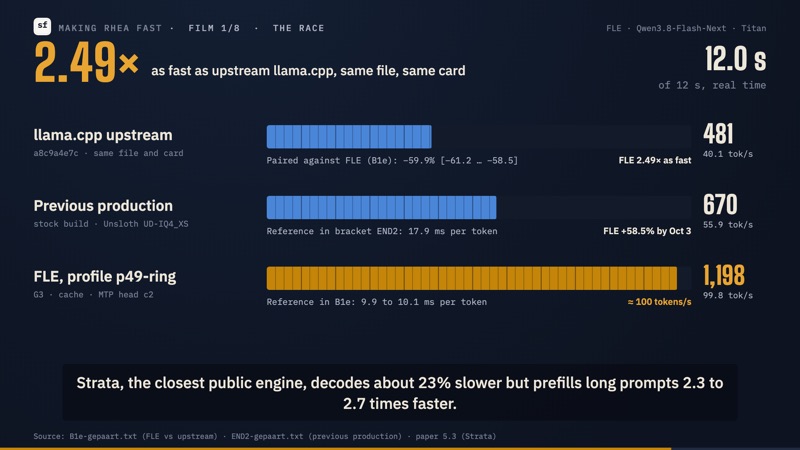 0:33 1/8 The Race
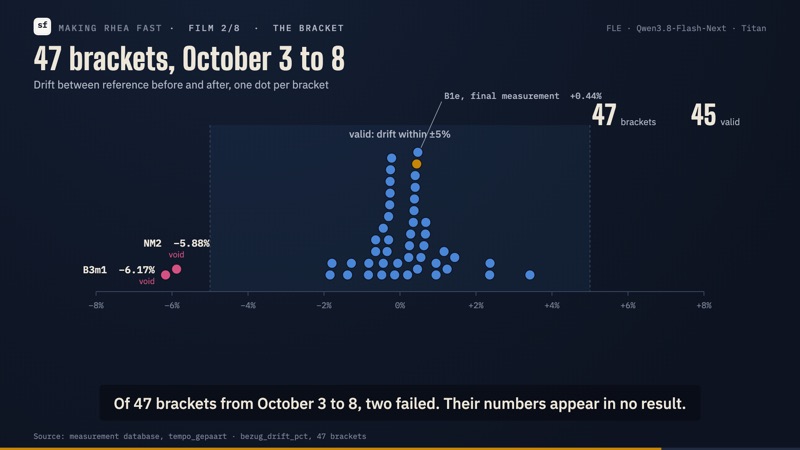 0:34 2/8 The Bracket
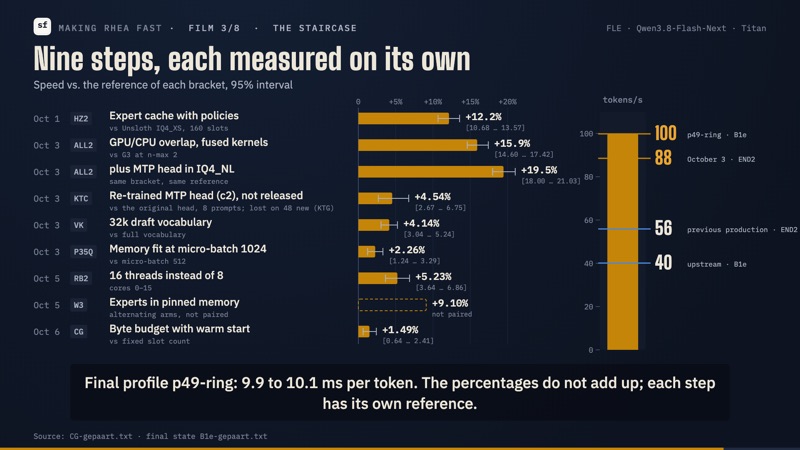 1:03 3/8 The Staircase
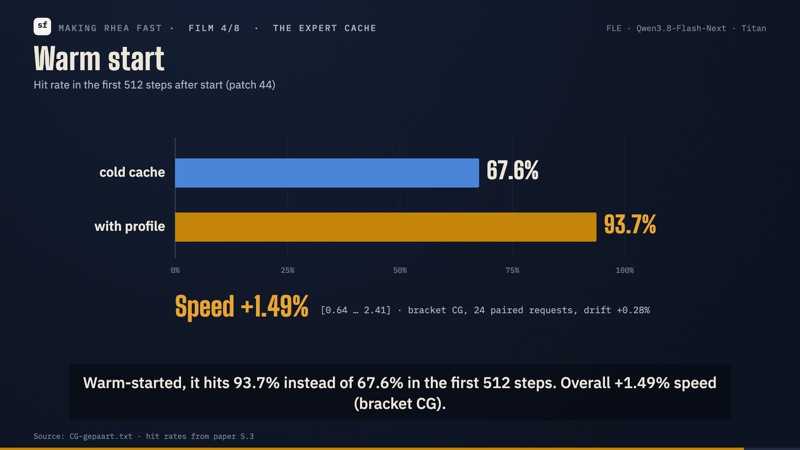 0:59 4/8 The Expert Cache
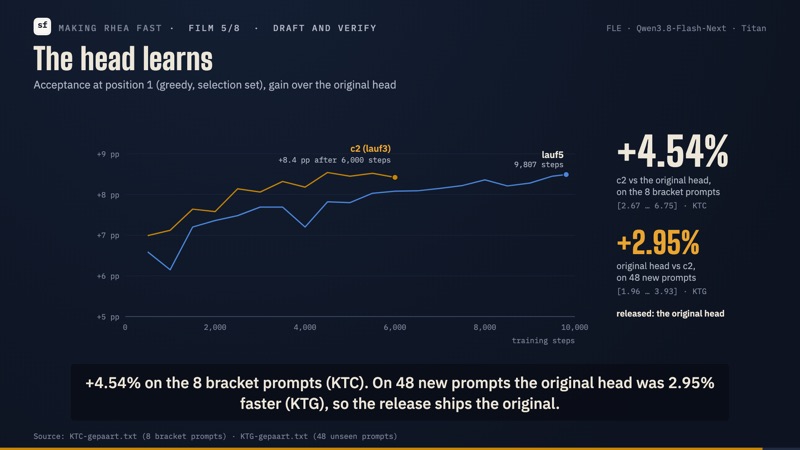 1:00 5/8 Draft and Verify
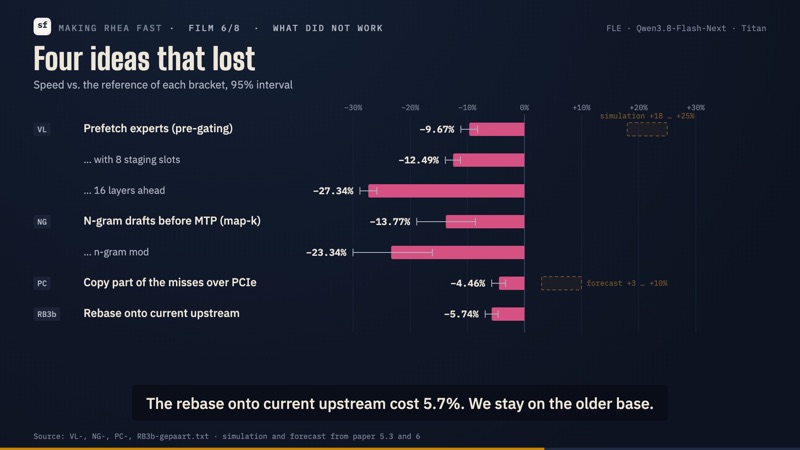 0:56 6/8 What Did Not Work
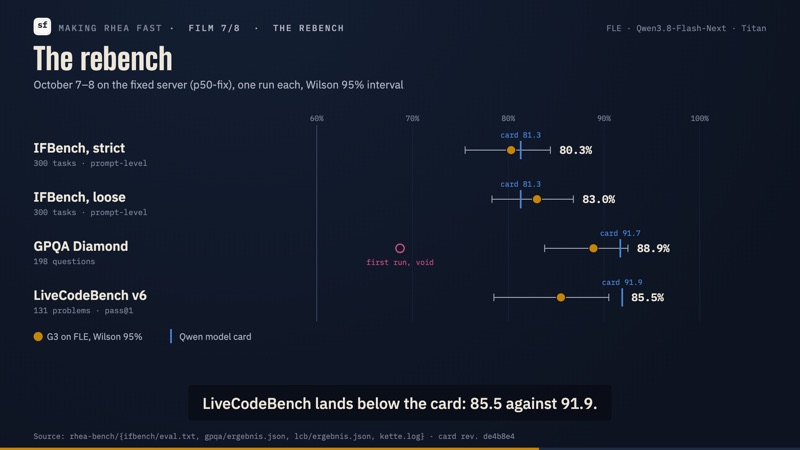 0:58 7/8 The Rebench
 0:58 8/8 Why We Do This
Alle acht als ein Film (6:59) ↗ Playlist auf YouTube ↗ Englisch, Untertitel eingebrannt. Links führen zu YouTube.
Loslegen
$ git clone https://github.com/sirfyyn/FastLocalExperts
$ cmake -B build -DGGML_CUDA=ON -DCMAKE_BUILD_TYPE=Release
$ cmake --build build --config Release -j
Alle Zahlen gelten für die im Bericht genannte Maschine (eine 32-GB-GPU, 120 GB RAM, 16 Kerne) und Konfiguration. Technical Report ↗